Agent 架构详解:四种模式与五个框架
学习总结:梳理 Workflow、Supervisor、Hierarchical 与 Swarm 四种协作模式,对比 LangGraph、CrewAI、MAF、OpenAI Agents SDK 和 Claude Agent SDK 的实现方式与取舍。
这篇学习总结围绕四种 Agent 协作模式展开,记录各自的控制流、适用场景,以及五个框架的实现方式与取舍。
文章导航
Workflow (流程编排)
Workflow 到底是什么
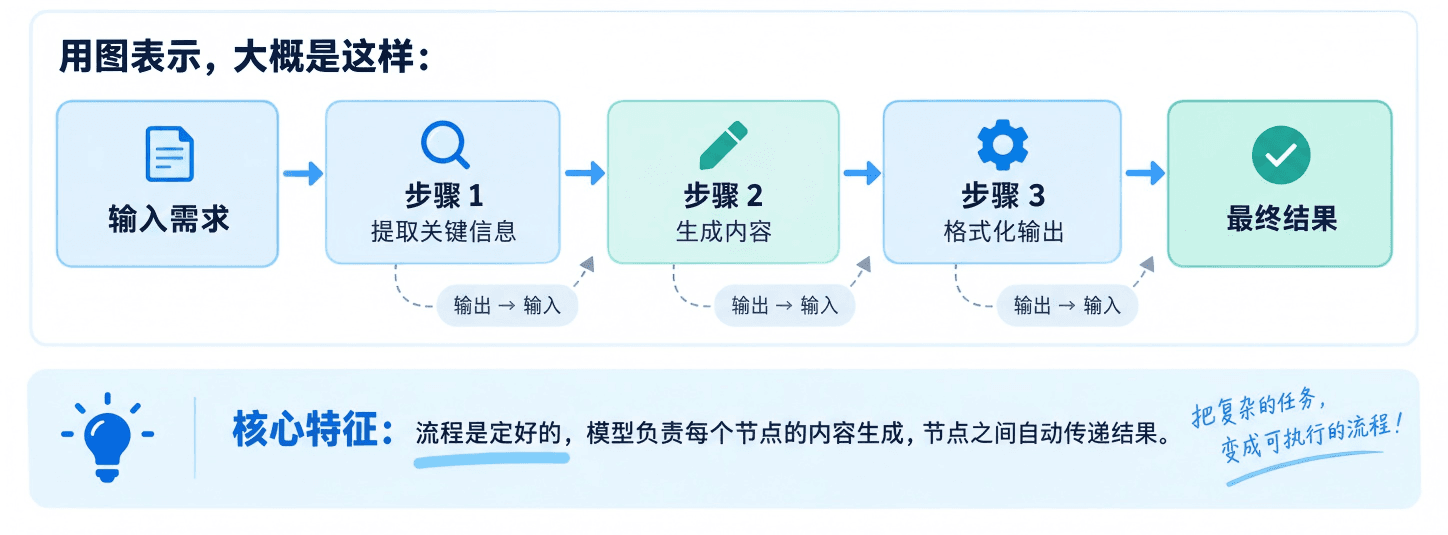
拆开来说,Workflow 其实就是三件事拼在一起: 控制流固定、模型只管填内容、上一步的输出直接喂给下一步 。
用图表示大概是这样:
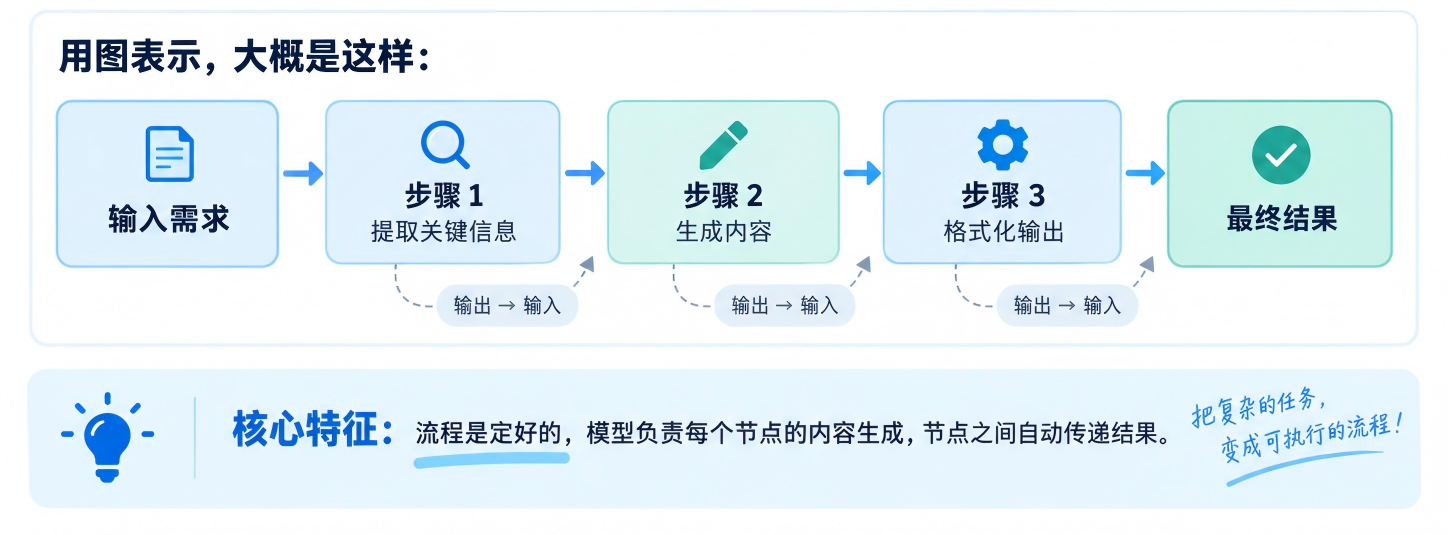
具体就是:
Ⅰ.顺序焊死在代码里 。研究员干完活,代码逻辑上就是下一步该轮到写作者了,这不是模型“想”出来的,是开发者写在程序里的。整个执行过程中,模型没有一次“我接下来该交给谁”的决策权。
Ⅱ.模型的角色被压缩到很窄的一件事上 :在自己这一站把活干好,而不是操心“下一站去哪”。这个区听起来很小,但决定了整个系统的可预测程度——你不需要担心模型会不会临时决定跳过某一步,因为它压根没有这个选项。
Ⅲ.上一道工序的产出,原样成为下一道工序的输入 。研究员产出的要点直接喂给写作者,写作者写出的初稿直接喂给编辑,整条链路上数据的流向是单向且确定的,没有“绕回去重做”这回事,这其实就是大部分模型里面提到的的 Prompt Chaining 。
这套东西为什么稳?原因也很直白:
结果可预测: 同样的流程,不会因为模型“临时想法变了”跳过编辑这一步。
出问题好查: 最终结果不对, 直接倒着查是哪个环节出了偏差 ,不用去翻一个复杂 Agent Loop 里到底发生了什么。
好治理: 每个节点都是独立的一次模型调用,想单独监控、限 Token、换模型、设超时、加质量检查,都可以 针对某一个节点单独做 ,不影响别的环节。
缺点/ 代价
第一个代价 : 延迟会线性叠加 。三道工序就是三次模型调用的时间加在一起,节点越多,端到端等待时间越长。这是拿顺序结构换确定性的固定成本,没有办法绕过去,只能在设计流程的时候提前算进去。
第二个代价 : 劣化会向下游放大 。如果第一步给出的要点本身就跑偏了,后续步骤不会替它纠错,只会在错误的基础上继续加工,最后整条流水线的产出全是错的。
越靠前的节点,质量门槛要卡得越严——它的错误会被无限传染下去。
所以流程编排上真正该重点盯的是 流水线最上游那一环 。还有一种情况值得提一句:如果你的流程经常需要在“A→B→C”和“A→D→C”之间切换,甚至要走“A→B→E→D→C”这种不固定路径,那纯 Workflow 就开始变得别扭了——这时候该考虑的是 Supervisor、ReAct 或者 Planning 这类更动态的架构,这个我们放到后面的文章里聊。
落到判断标准上,大概是这样一张表:
| 任务特征 | 推荐架构 |
|---|---|
| 步骤固定、顺序稳定 | Workflow |
| 需要动态选择该派谁去做 | Supervisor |
| 需要根据结果决定下一步 | ReAct |
| 多个任务可以同时进行 | Parallel |
| 需要多角度辩论、复杂任务拆解 | Debate / Planning |
「不要因为用了 Multi-Agent,就默认觉得需要“自主协作”。很多时候,最好的架构就是老老实实一条线走到底。」
3.同一条流水线,五个框架各是什么写法
拿“研究员→写作者→编辑”这个案例, 在五个主流框架里各跑了一遍 ,感受一下它们对“流程编排”这件事的态度差别。
LangGraph
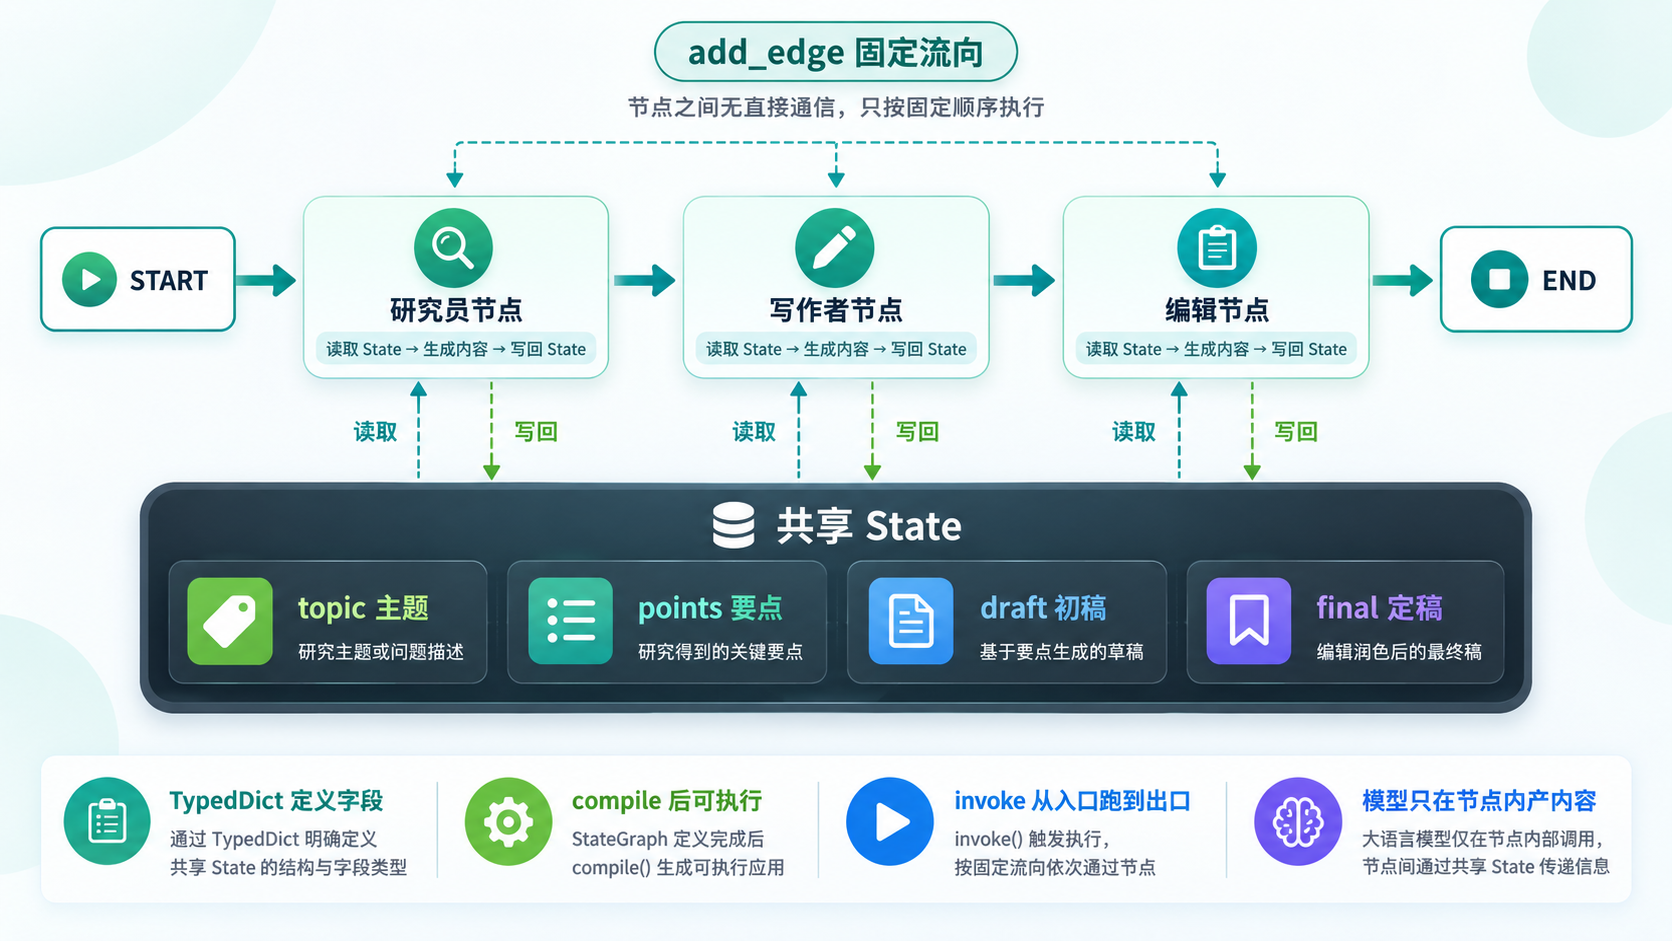
走的是“画图连边”的路子。核心是 StateGraph ,State 是一张贯穿全程的共享表,每个节点是一个函数,读一份共享状态、写回自己那一格,节点之间用 add_edge 连起来,START 到 END 焊死一条路径。它的优势在于 控制粒度最细 ——你可以针对每一个节点单独检查状态、控制 Token 消耗、加条件路由、甚至做断点续跑。适合那种要求生产级可观测性的复杂流程。
CrewAI
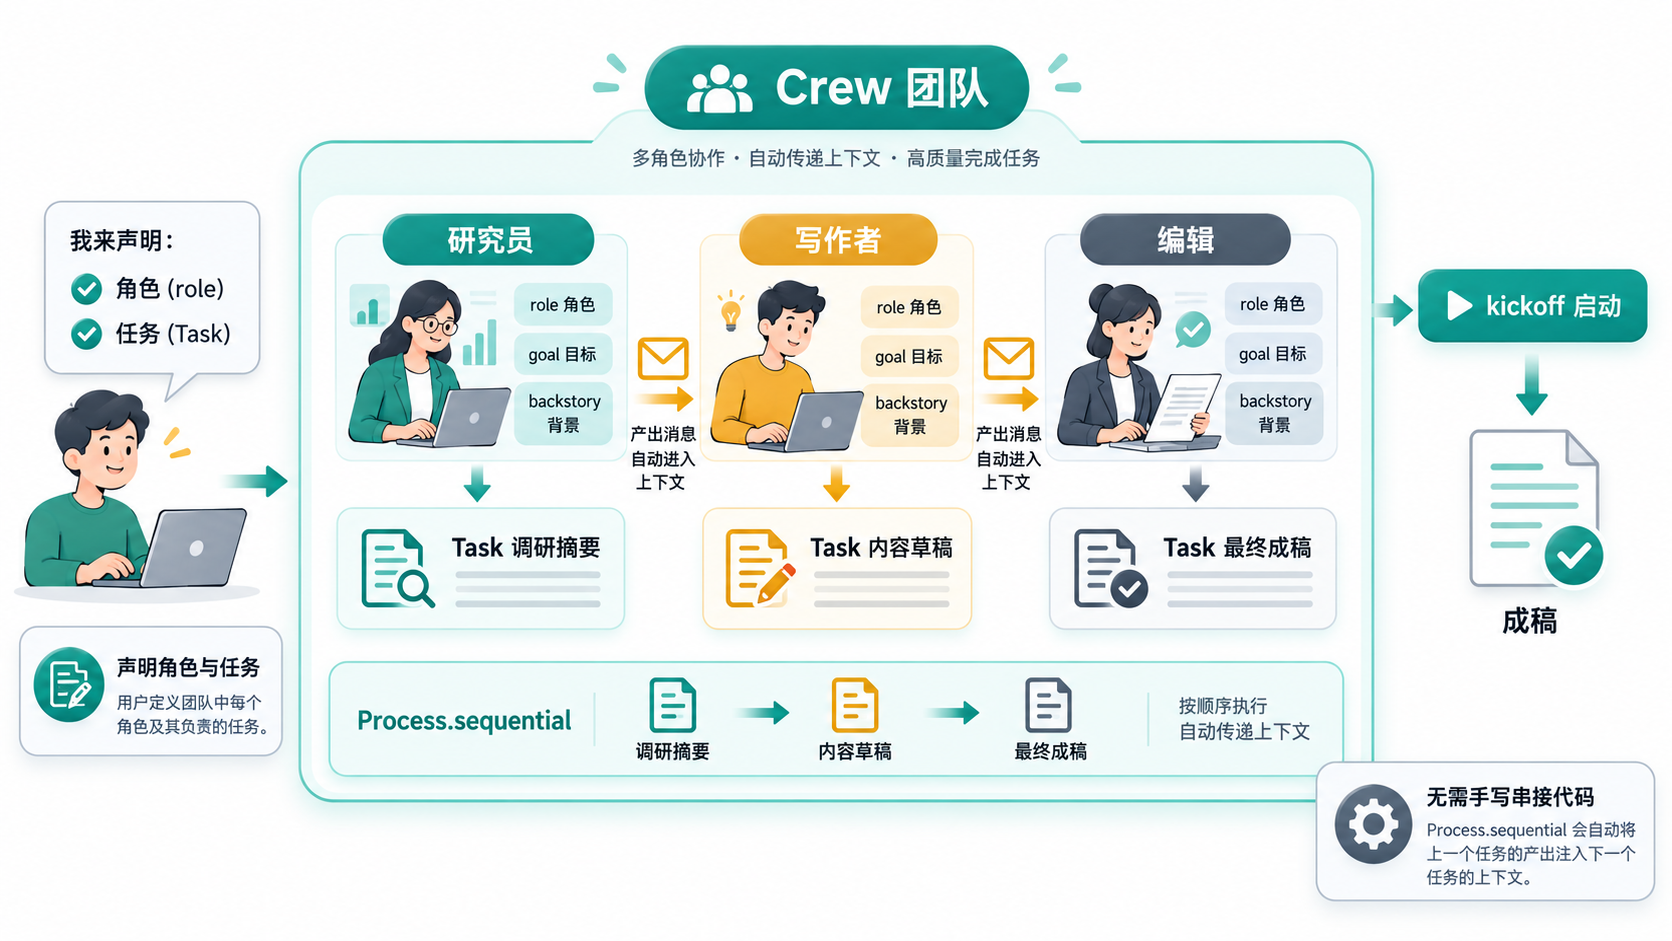
完全是另一套世界观,它不关心“连边”,关心“分工”。用 role 、 goal 、 backstory 三件套定义一个角色,比如“内容研究员,擅长先查资料再下笔”,然后用 Task 绑定角色和任务,最后用 Process.sequential 一句话声明按顺序执行。上一个 Task 的产出会自动进入下一个 Task 的上下文,这部分完全不用自己写。角色化的写法非常直观, 原型速度是这五家里最快的 ,很适合内容生产、市场调研这类线性任务。
MAF
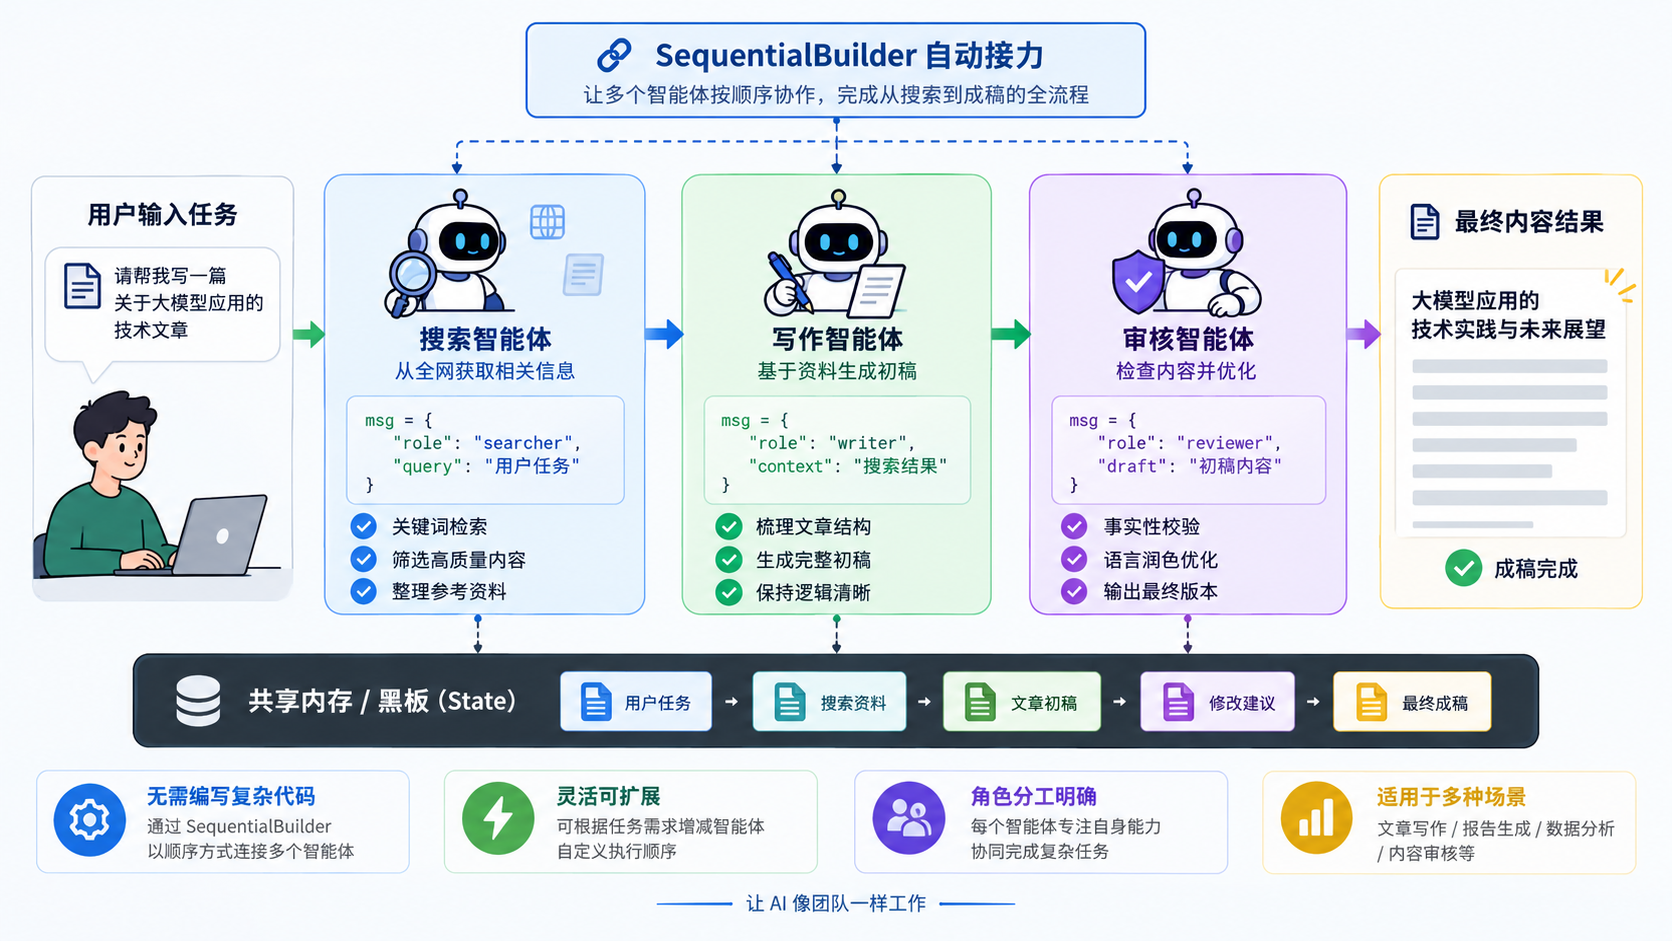
AutoGen 和 Semantic Kernel 合并之后的接棒者,提供了一个专门的构造器叫 SequentialBuilder ,你只需要把几个 Agent 按顺序塞进 participants 列表, 一行代码编译出一条顺序流水线 。它把“上一步喂给下一步”这件事完全收进了框架内部,好处是省事,代价是 过程有点黑箱 ——每个 Agent 具体说了什么,得从返回结果里一条条捞出来看,不像 LangGraph 那样每个节点都摆在明面上。
OpenAI Agents SDK
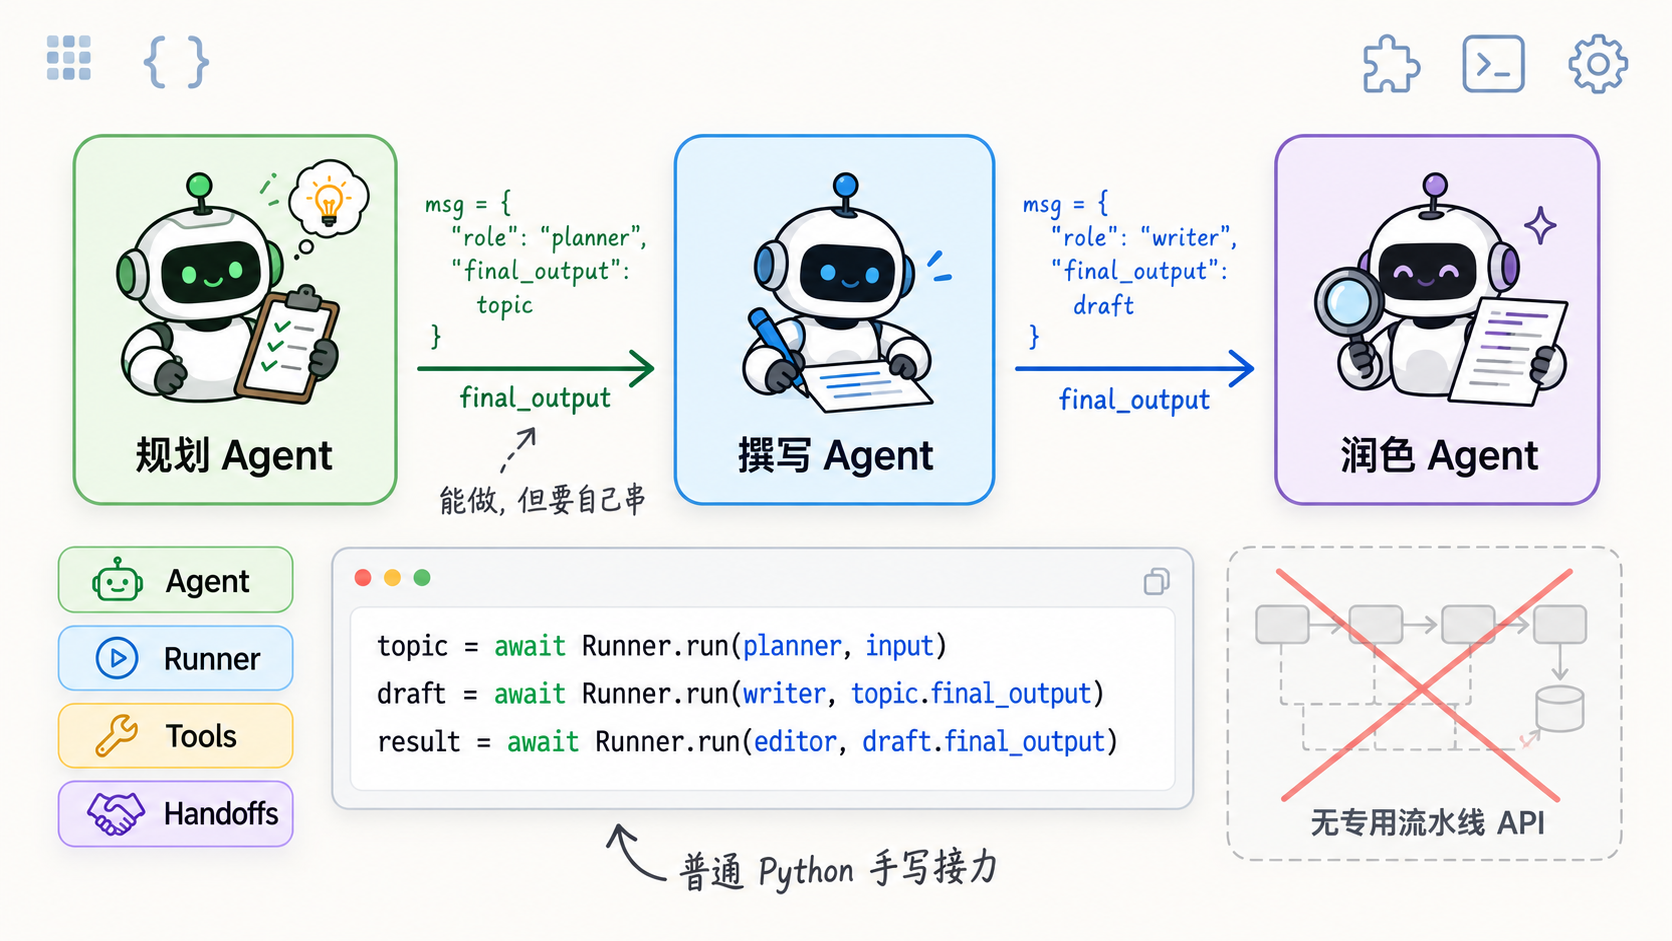
走的是完全不同的哲学:没有专门为流水线设计的 API,官方的推荐姿势就是“代码驱动编排”——自己用普通的 Python 代码把上一个 Agent 的输出喂给下一个。跑完第一个 Runner.run 拿到 final_output ,直接当输入传给第二个 Runner.run ,如此接力。 三行手写代码就是整条流水线的骨架 ,没有任何框架帮你藏起来。极简,也因此完全可控,缺点是流程一旦复杂起来,手写的接力代码会越写越多。
Claude Agent SDK
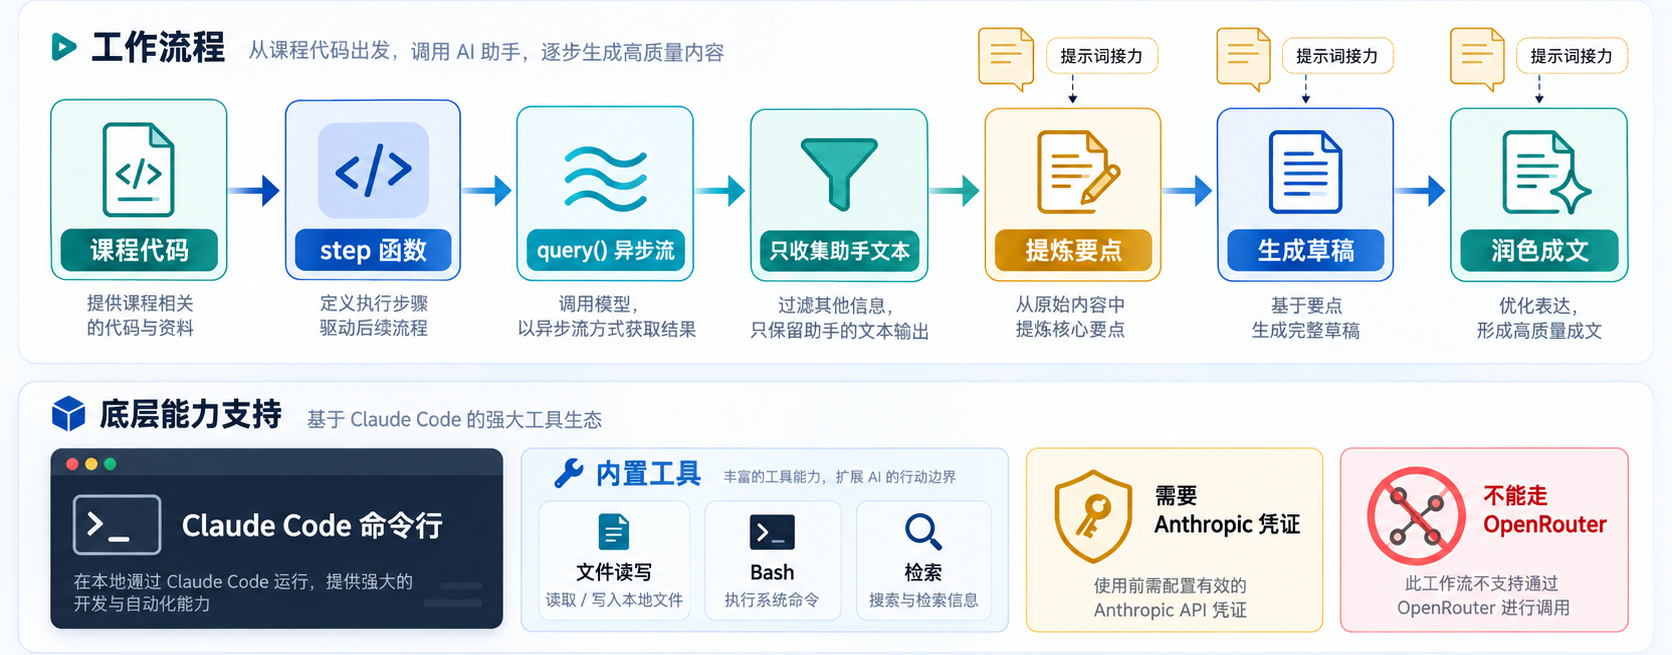
本质是 Claude Code 命令行工具的可编程封装,思路和 OpenAI SDK 相似,同样没有专用的流水线 API,靠多次调用 query() 朴素拼接—— 一次 query() 就是一道工序 ,上一次的回复文本拼进下一次的提示词里。
一句话概括这五家的差别:LangGraph 和 MAF 把“接力”这件事 焊进了框架 ,你只管声明结构;OpenAI SDK 和 Claude SDK 把这件事 交还给你自己写几行代码 。
五个框架的缺陷
CrewAI
走 OpenRouter 这类第三方接入端点的时候,模型名前面必须带上 openrouter/ 这个前缀,少了它 litellm 那条链路会直接报错说找不到模型提供方, 报错信息不太容易第一时间联想到是前缀的问题 。
OpenAI Agents SDK
默认会把运行轨迹回传给 OpenAI 官方的 tracing 服务,一旦你走的是第三方端点(比如 OpenRouter), 不手动关掉这个追踪 ,就会因为凭证对不上而报错,这一步很容易被漏掉。
Claude Agent SDK
给 Agent 挂自定义工具时, 工具函数必须写成 async ,而且返回值必须是 {"content": [...]} 这种结构,直接返回一个字符串会被框架判定为格式错误。
4.到底该怎么选
| 框架 | 支持等级 | 核心抽象 | 通信方式 | 更适合 |
|---|---|---|---|---|
| LangGraph | 原生 | StateGraph + add_edge | 共享状态(黑板) | 生产级、需要精细控制的复杂流程 |
| CrewAI | 原生 | Process.sequential | 消息传递(框架代劳) | 快速原型、角色驱动的线性内容工作流 |
| MAF | 原生 | SequentialBuilder | 共享对话(黑板) | 企业级顺序编排 |
| OpenAI Agents SDK | 官方示例级 | Runner.run 手动接力 | 消息传递(手动) | 简单、确定性的 Agent 串接 |
| Claude Agent SDK | 官方示例级 | 多次 query() | 消息传递(手动) | 已在 Claude 生态、想自己掌控流程 |
这里有个挺有意思的细节,就是“通信方式”这一列。LangGraph 和 MAF 走的是 共享内存 这种模式——所有节点读写同一份状态或同一条对话,谁也不直接跟谁说话,全靠这块“黑板”传递信息。而 CrewAI、OpenAI SDK、Claude SDK 走的是 消息传递 ,只不过 CrewAI 是框架帮你把上一个 Task 的产出自动塞进下一个的上下文,后两家则要你自己动手把返回值拼进下一次调用的提示词里。 这两种模式没有优劣之分 ,只是设计取向不同,了解这层区别,选框架的时候会更有底。
落到实际选型,大概是这么个思路:
最快出原型 → CrewAI: 只是要一条线性的内容流水线、追求最快出原型,CrewAI 的 角色化写法是最短路径 。
精细控制 → LangGraph: 如果这条流水线需要在每个节点做状态检查、Token 控制、条件路由,或者要支持 断点续跑这类精细操作 ,就换 LangGraph。
Microsoft 生态 → MAF: 已经在用 Microsoft 生态、想要一个 开箱即用的顺序构造器 ,MAF 是最省心的。
完全掌控 → OpenAI / Claude SDK: 如果你不想引入太多框架依赖,想 自己完全掌控接力逻辑 ,OpenAI SDK 或 Claude SDK 都可以,取决于你用的是哪家的模型生态。
从这张对照表也能看出一个更大的判断: 流程编排是几种多 Agent 协作模式里门槛最低的一种 ,五家框架无论是原生支持还是官方示例级,都能干净地实现出来。
5.Workflow 和 Agent,到底是什么关系
这里想强调一个经常被搞混的点: Agent 和 Workflow 不是一个二选一的问题 。正确的理解应该是这样:
Workflow
 ├── Research Agent
 ├── Writer Agent
 └── Editor Agent
「Workflow 是外部控制流,Agent 是内部执行单元。」
换句话说, Workflow 决定“谁什么时候干什么”,而 Agent 决定“这一站具体怎么干” 。一个系统完全可以既是 Workflow、又内含真正的 Agent——就像本文里的例子,每个工序其实都是一个能自主决定要不要调用搜索工具的真 Agent,只是它们之间“谁先跑、谁后跑”这件事 被代码焊死了 。
这也是为什么“多 Agent”和“自主协作”经常被混为一谈, 但其实是两码事 。你完全可以搭一个由三个真正智能的 Agent 组成的系统,但 整体架构依然是最朴素的流水线 。
总结
多 Agent 系统的架构设计, 不是越自主越高级 。如果业务本身的流程就是 A 到 B 到 C,那最合适的架构,很可能就是 老老实实的 A 到 B 到 C ,不需要为了显得“智能”而额外塞进一层决策。
能用 Workflow 解决的,就不要急着上 Supervisor ;能用 Supervisor 解决的,就不要一上来就搞复杂的 Planning。
Supervisor (中心辐射结构 架构 )
Workflow 里代码说了算, Supervisor 里模型说了算——当任务路径没法提前写死,把决策权交给模型才是真正的工程解法。
先说一个很多人都会遇到的需求:“帮我写一份《2026 年多智能体协作模式现状》的研究简报。”
看着挺简单一任务,但只要你真打算找几个 Agent 分工来干,麻烦马上就来了。你大概会这么分:一个负责讲 技术原理 ,一个负责讲 落地场景 ,最后还得有人把两边的内容捏到一起,写成一段像样的简报。
分工方案想清楚了,新问题又冒出来了:这活儿到底 谁先干、谁后干 ?两个专家是都得问,还是看情况问一个就够?什么时候算问完了,可以开始收尾?
如果你写过 Workflow(流程编排)就知道,这类系统最大的好处是 确定性 ——A 做完交给 B,B 做完交给 C,一步一步都是提前写死在代码里的。可这个好处放到“研究简报”这种任务上就不太好使了:先问技术还是先问应用、要不要追问、什么时候信息够了可以收口,这些决定很难在写代码的那一刻就想清楚,得看具体问题 临场判断 。
于是就有了一次很关键的转变:
Workflow:代码决定下一步。Supervisor:模型决定下一步。
一个 中央主管 Agent 坐镇中间,任务来了它看着办——派给谁、派多少、什么时候综合,全是它临场拿主意。这就是这篇要讲的 Supervisor 集中调度模式 。
Supervisor 到底是什么
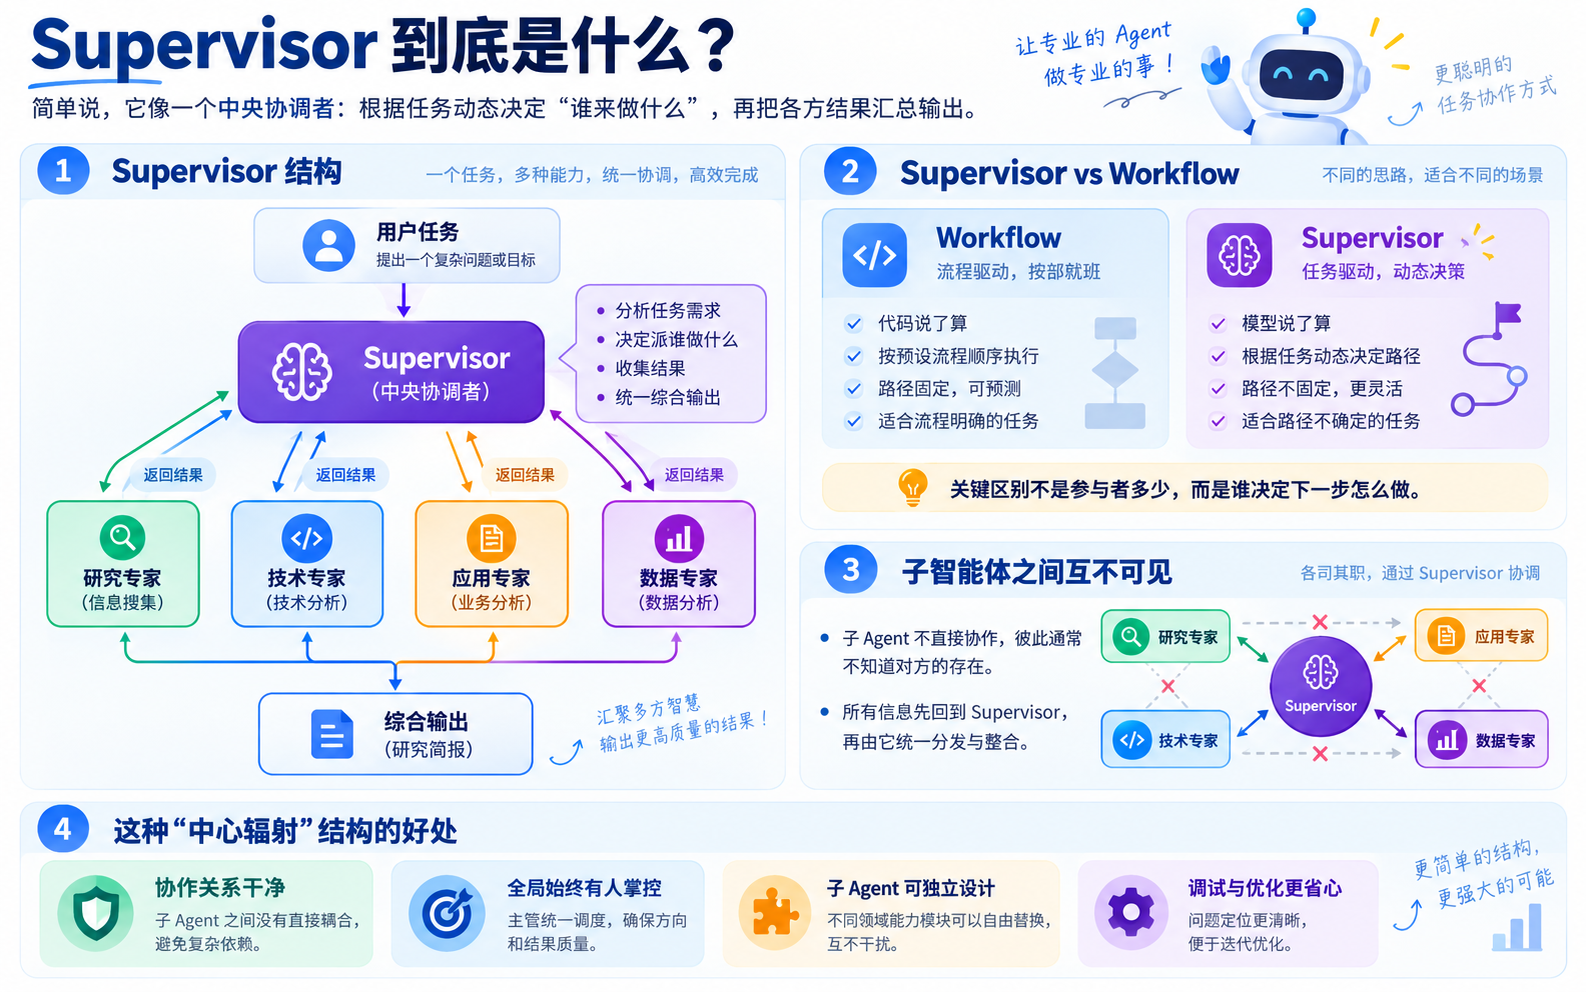
简单点说:一个 中央协调者 ,根据任务动态决定“派谁做什么”,收集结果后再统一综合。
它跟 Workflow 最根本的区别,不是“有没有多个 Agent 参与”,而是 “下一步做什么”这件事到底是谁说了算 。Workflow 里是代码说了算,Supervisor 里是模型说了算。同一个研究简报任务,换个提问角度,主管派单的路径可能就不一样——这正是它能应付“路径没法提前定死”这类任务的原因。
这个结构还有一条经常被忽略、但特别关键的特点: 子智能体之间互不可见 。技术专家根本不知道有个应用专家存在,应用专家也完全不清楚技术专家说了什么,它们各自只跟主管单线联系,彼此没有任何连接。所有的信息都要先汇到主管这一个点,再由主管往外分发。
这种“中心辐射”式的结构好处很直接: 协作关系干净 、全局始终有人掌控、子 Agent 可以各自独立设计,调试起来也相对省心。
但代价也埋在这儿了—— 主管会不会变成瓶颈? 这个问题后面局限性那一节会专门聊。
派单其实有两种方式
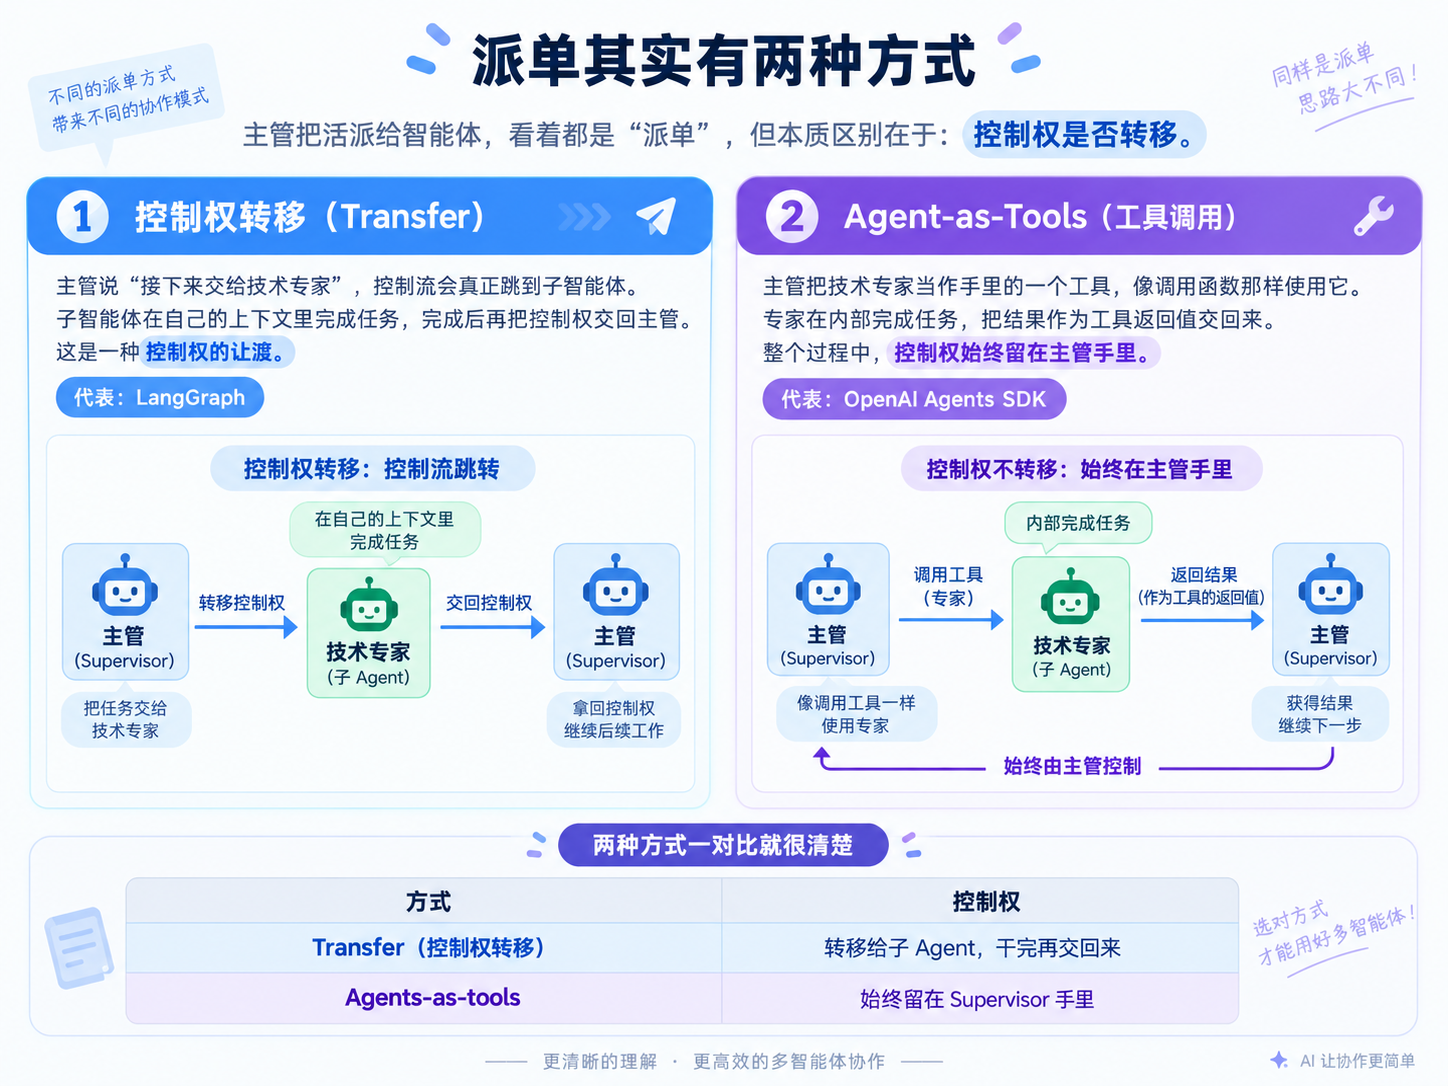
主管把活派给子智能体,看着都是“派单”,其实底层有两种截然不同的做法,区别就在于 控制权转不转移 。
第一种,控制权转移。 主管说“接下来交给技术专家”,控制流是真的跳过去了——技术专家在自己的上下文里把活干完,再把控制权交回主管。说白了,这次“派单”本质上就是一次 控制权的让渡 。LangGraph 走的就是这条路。
第二种,Agent-as-Tools,控制权压根不转移。 主管把技术专家当成手里的一个工具,像调一个普通函数那样“调用”它——技术专家在内部把活干完,把结果当返回值交回来,主管拿到结果接着自己往下推理。从头到尾, 控制权就没离开过主管的手 ,专家只是被它顺手调用了一下。OpenAI Agents SDK 用的是这一种。
Supervisor 和 Swarm的区别
这里有个很容易混的概念,值得提前打个预防针。
Supervisor 的逻辑是: “我派你干活,但最终还是我负责。” 不管走哪种派单方式,控制权最后一定会回到主管手里。
而另一种叫 Swarm 的模式,逻辑完全不同: “我把方向盘真正交给你。” 接下来该由谁接手,是由另一个 Agent 自己决定的,主管不再兜底。
判断起来其实很简单:
「Supervisor:“你去做,做完回来告诉我。” Swarm:“接下来由你负责。”」
所以 as_tool 只是“调用了一下”,而 handoff 才是真正意义上的 控制权交接 。这两者的区别,后面聊 Swarm 的时候会专门展开,这里先留个印象。
统一用一个案例,把五个框架放一起比
接下来要讲的五个主流框架—— LangGraph、OpenAI Agents SDK、CrewAI、MAF、Claude Agent SDK ——全部用同一个案例来实现:那份“2026 年多智能体协作模式现状”的研究简报。技术维度交给技术专家,应用维度交给应用专家,主管负责最后综合。
LangGraph:控制权转移型的典型代表
LangGraph 对 Supervisor 这种模式是原生支持的,靠的是一个专门的扩展包 langgraph-supervisor ,核心是一个函数: create_supervisor 。传入一组子智能体和一个主管模型,它就能自动把“主管+一组专家”的星形结构装配好,省去手动连边、手动写派单工具的功夫。
具体实现分两步。先用另一个函数 create_react_agent 造出技术、应用两个专家——这个函数能造出会自己判断要不要调工具、能多轮推理的 ReAct 智能体,这两个专家不挂任何外部工具,纯靠模型自身知识各管一摊。然后用 create_supervisor 把两个专家和主管模型装配起来,它会自动给主管装上transfer_to_tech_expert 、 transfer_to_apply_expert 两件派单工具。
这里最值得注意的一点是: 代码里没有任何一行把执行顺序写死 。先派谁、要不要两个都派,全是主管在运行时临场决定的。
实际跑起来的轨迹大概是这样:主管先把控制权转给技术专家,技术专家答完转回主管,主管再转给应用专家,应用专家答完再转回来,最后主管自己把两份材料综合成一段简报。每一步都是模型当场生成的顺序,不是我们预先写好的。
状态是状态,日志是日志。如果你用 invoke 跑完再打印最终的 messages,看到的是一份按对话结构整理好的最终状态,专家的回答插回去的位置是按消息配对规则排的,跟实际执行的先后顺序不一定对得上。想看“到底谁先干活、谁后干活”的真实时间线,得用 stream 边跑边打印,在事件发生的当下就把它记下来。分清这两样,能省下不少“顺序怎么不对”的困惑。
「一句话点评:LangGraph 控制得最细,派单轨迹完整可见。」
OpenAI Agents SDK:把专家当工具用
OpenAI Agents SDK 走的是另一条路——把每个专家包装成主管手里的一件工具,也就是前面说的第二种控制权形态。它内建了一个方法叫 agent.as_tool() ,专门用来把一个 Agent 转成另一个 Agent 可调用的工具,对 Supervisor 这种模式同样是原生支持。
实现起来就两步:先把两个专家定义成普通的 Agent,然后在定义主管的时候,用 as_tool 把它们分别包成 ask_tech 、 ask_apply 两个工具,挂进主管的 tools 列表里。运行时主管把专家当成普通工具调用,调一次拿回一份答案,先调哪个、什么时候综合,全由主管自己拿主意。
跟 LangGraph 恰好形成对照:LangGraph 那边控制权是转移给专家、专家跑完再交回来;这边 控制权全程没离开过主管 ,它把专家当函数调,自己一直坐镇。
「一句话点评:最简洁,不到百行代码就能跑起来,控制权不转移。」
CrewAI:改一个参数,流水线秒变主管调度
如果你已经在用 CrewAI 写 Workflow,这一节会让你有点意外——想从流水线切换到 Supervisor,改动小到有点不真实。
CrewAI 里流水线用的是 Process.sequential ,切到 Supervisor 只要换成 Process.hierarchical ,再多传一个 manager_llm 参数。CrewAI 会自动替你造一个 manager,由它动态把任务派给手下的专家,再把结果汇总起来。
具体到代码上只动两处:Task 不再绑定某个具体的 Agent,把“派给谁”的决策权让出来;Crew 里的 process 从 sequential 换成 hierarchical,并多传一个 manager_llm。就这两处改动,原本按顺序逐个执行的团队,就变成了一个真正的 Supervisor。这也挺能说明 CrewAI 的设计思路: 同一套角色定义,换个 Process 参数,就能在不同协作模式之间自由切换 。
「一句话点评:改一个枚举值就从流水线变 Supervisor,上手门槛全场最低。」
一个命名陷阱
CrewAI 的这个 Process.hierarchical ,名字里带着“hierarchical(层级)”这个词,但它实际的机制,其实就是本文一直在讲的 Supervisor——一个 manager 把任务派给几个平级的专家,再统一汇总, 本质上只有一层 。
而真正的 Hierarchical(分层协同)指的是 “主管手下还有主管” 的多层嵌套结构,比如一个 CEO 管着两个 Manager,每个 Manager 底下再各自带几个执行的 Agent。这跟 CrewAI 这个枚举值的命名完全是两码事。
所以下次再看到“hierarchical”这个词,先别急着按字面理解,得先看清楚它到底是 单层还是多层 ——这俩虽然共用一个英文单词,但说的根本不是一件事。
MAF:主管从“调度员”升级成“项目经理”
前面三家的主管,干的活基本是“找专家、收答案、汇总”,属于比较轻量的调度员角色。MAF(微软的 Agent Framework)给出的是完全不同量级的方案,叫 Magentic 编排 ,名字来自微软研究院的 Magentic-One 多智能体架构,产品化之后就是 MagenticBuilder。
它跟前几家最大的不同是:这个主管不只是临场决定派给谁,还会先把任务拆成一份计划,专门用一份 “任务账本” 记着;派单过程中持续用 “进度账本” 盯着进度;如果发现执行卡住了,它才会推翻计划重新规划——注意这不是每次都要走完的固定流程,而是一种专门应对异常情况的机制,大多数时候不会触发。
具体实现上,先用 as_agent 创建 技术、应用两个专家和一个主管,三个都是普通的 Agent,主管的“项目经理”能力是由 MagenticBuilder 在装配的时候注入进去的;然后把专家列表和主管一起交给 MagenticBuilder,配一个 max_round_count 参数限制总轮数。
这个 max_round_count 特别值得说一句:它是一道 确定性保险丝 。主管的规划和派单交给模型自主决定,但用轮数上限这种确定性的东西兜住它,防止它跑飞、无限循环下去。这其实也是整个 Agent 工程里一个挺重要的原则—— 模型可以拥有决策权,但边界不能也交给模型 。
「一句话点评:五家里最重型的主管,带任务账本+进度账本,适合复杂、长程的任务;简单任务上它属于高射炮打蚊子,没必要。」
Claude Agent SDK:Anthropic 自己的看家本领
Supervisor 是 Claude Agent SDK 真正拿手的模式。它的机制叫 subagents(子智能体) ,在主智能体下面挂一组各有专长的子智能体,主智能体根据每个子智能体的 description 字段自动判断该把任务派给谁,子智能体在各自隔离的上下文里干活。这种“一个主智能体编排一组子智能体”的结构,业界管它叫 orchestrator-worker ,正是 Anthropic 自家那套多智能体研究系统的核心架构。
具体实现上,先用 AgentDefinition 定义两个专家,每个都要写清楚两个关键字段: description (这个专家擅长什么,主智能体就是靠这个来判断要不要派给它)和 prompt (它具体怎么干活)。定义好之后,把它们以字典形式塞进配置里,连同主智能体的总指令一起交给 query() 执行。
运行时主智能体会读各个 subagent 的 description,自己判断技术维度该派给谁、应用维度该派给谁——我们只需要下达一句“分别委派、收齐后综合”的总指令,具体怎么派、怎么综合全由它自己完成。
有意思的是,实测下来 Claude SDK 给出的综合结果往往更具批判性,会主动指出 错误级联、编排成本高、可观测性不足 这些瓶颈,甚至给出“简单任务性价比不如单 Agent”这样的判断——这恰好也呼应了本文最后要讲的那个道理。
「一句话点评:Anthropic 自家看家模式,经过生产实证,子智能体在隔离上下文里干活,产出往往更扎实。」
家横向对比,到底该选谁
| 框架 | 出品方 | 核心原语 | 一句话点评 |
|---|---|---|---|
| LangGraph | LangChain | create_supervisor | 控制最细,派单轨迹完整可见 |
| OpenAI SDK | OpenAI | agent.as_tool | 最简,控制权不转移,不到百行 |
| CrewAI | CrewAI | Process.hierarchical | 改个枚举值就变 Supervisor |
| MAF | Microsoft | MagenticBuilder | 最重型:双账本+轮数保险丝 |
| Claude SDK | Anthropic | subagents | 看家模式,生产实证 |
这张表最值得留意的一点是: 五家对 Supervisor 全都是原生支持 ,没有一家是勉强拼凑出来的。这也印证了业界的一个共识——把 Supervisor 和更复杂的 Hierarchical 分层协同合在一起的 orchestrator-worker 家族,占了 2026 年生产级多智能体部署的 大约七成 ,是目前最主流的结构。其中集中调度这种最基础的形态,更是被 Anthropic 列为“单个智能体扛不住时第一个该考虑的方案”,因为它对子智能体的假设最少,几乎什么场景都能往上套。
具体怎么选,大致可以这么想:
要 派单轨迹看得清 、能在每个节点上精细控状态,选 LangGraph;
要 代码最短 、最快搭出一个能用的主管,选 OpenAI SDK 的 agents-as-tools,不到一百行就能跑起来;
已经在用 CrewAI 写流水线、想顺手加个主管,把 Process 换成 hierarchical 就行,不用大改;
要面对更复杂、更长程的任务,MAF 的 MagenticBuilder 给的是带双账本的重型主管;
团队本就在 Anthropic 生态里、想要经过生产实证的 orchestrator-worker,Claude SDK 的 subagents 就是它的看家本领。
什么时候不该用 Supervisor
多 Agent 不是天然比单 Agent 好,这一点需要单独强调一下。
情况一:任务本身很简单
如果一个 Agent 就能把问题答明白,没必要专门搭个主管、配几个专家来处理——token 消耗更多、延迟更高、系统更复杂、出问题也更难排查。
情况二:专家之间需要频繁直接交流
Supervisor 的结构本质上是 A → 主管 ← B,信息不能在 A 和 B 之间直接流动。如果任务需要高频的互相讨论、上下文要动态传来传去、对话焦点一直在漂移,Supervisor 这种中心辐射结构就不太合适了。
情况三:主管本身变成了瓶颈
所有信息最终都要经过中心节点汇总,主管的上下文会随着专家结果的增多而不断膨胀,带来的是 token 消耗和延迟的双重代价——这是集中式架构绕不开的成本。
判断标准:任务能拆成几个独立子任务交给专家、又需要中心统筹综合,Supervisor 就合适;子任务之间需要频繁互相传递、对话焦点不断漂移,那就不是它的主场。
总结
Supervisor 不是“更高级的 Agent 架构”,而是当 任务路径没法提前写死在代码里 的时候,把“下一步做什么”这个决策权交给模型的一种工程化方式。
它的好处很实在:多 Agent 专业分工、中央全局控制、动态任务分派、结果统一综合,可观测性也相对清楚。但代价同样要记住: 中央瓶颈、上下文膨胀、token 和延迟成本 。把这两边放在一起权衡,才能判断一个任务到底该不该上 Supervisor。
Hierarchical (分层协同)
Hierarchical 分层协同的本质,不是简单地“多加几层 Agent”,而是每一层主管都能自己决定往下派给谁——说到底,它就是 Supervisor 的递归复合。
一个 Agent 原本要 独自搞定整个软件交付 ——前端、后端、数据库、接口全归它一个人管。
一开始还好。任务一复杂,问题就冒出来了: 上下文越堆越长 ,它要记住的细节越来越多,决策链条越拉越长。慢慢地,这个 Agent 变成了什么都要管一遍的 巨型单体 ,谁也说不清它现在到底在忙前端还是后端。
一个很自然的问题就出来了:如果 一个主管管不过来 ,怎么办?
答案不是继续往它身上塞工具、塞提示词,而是——给主管再配一个主管。
这就是 Hierarchical 分层协同 。
Hierarchical 的本质
「分层协同不是简单地“多加几层 Agent”,而是要求每一层主管都能自己决定往下派给谁,下级主管还能接着往下派。」
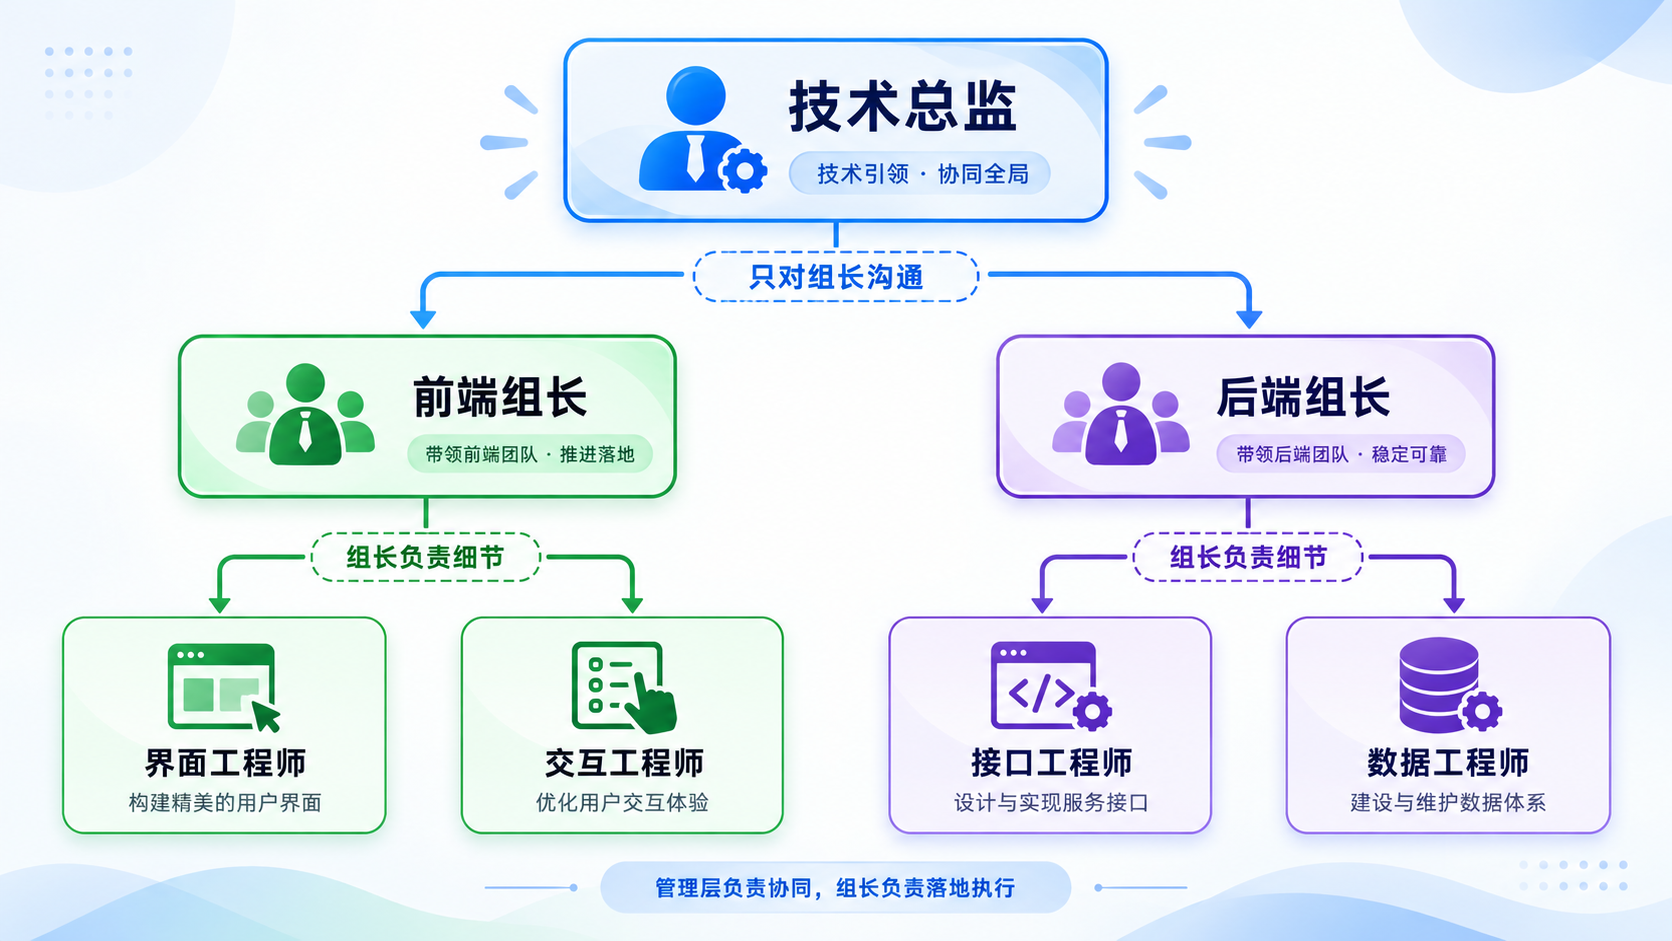
CTO 不直接指挥四个工程师,他 只对两个组长说话 ;组长再把拆好的活派给自己手下的工程师;工程师干完, 逐层往上汇报 。CTO 全程不需要知道前端用了哪个状态管理库,他只需要知道“前端这块已经完成”了。
看懂这张图你会发现一件事:这里面 没有任何新机制 。CTO 管两个组长,是一个主管带团队;组长管工程师,也是一个主管带团队。整个结构,不过是把“一个主管带几个专家”这个模式, 一层套一层地嵌套了两次 。
所以但凡你之前理解过 Supervisor 模式(一个主管派活给几个平级专家),Hierarchical 在概念上真没什么新东西——它就是 Supervisor 的递归复合 。
那这套结构值得费劲搭吗?值得,理由就是前面提到的那句话: 逐层收窄的上下文 。顶层永远只拿到最抽象的结论,细节被挡在下面几层。任务一旦复杂到需要分组分工——比如软件交付天然要分前端组、后端组——这种结构就比一个主管硬扛所有细节要合理得多。
当然代价也不是没有。 层级越多,调用链越长 ,token 消耗、延迟、错误传播路径都会跟着涨。这点先记在心里,后面讲到“什么时候不该用”还会回来聊。
真正有意思的问题在后面:五个主流的多 Agent 框架里,谁能把这套 “每层都自主派单” 的结构原生搭出来?答案可能有点反直觉—— 只有两家 。
2.Hierarchical原生支持的框架
LangGraph:主管的主管
LangGraph 做这件事做得最干净。关键就在于上一层用来搭 Supervisor 的 create_supervisor ,它编译出来的产物可以再被更上一层的 create_supervisor 当成一个普通 agent 来用。
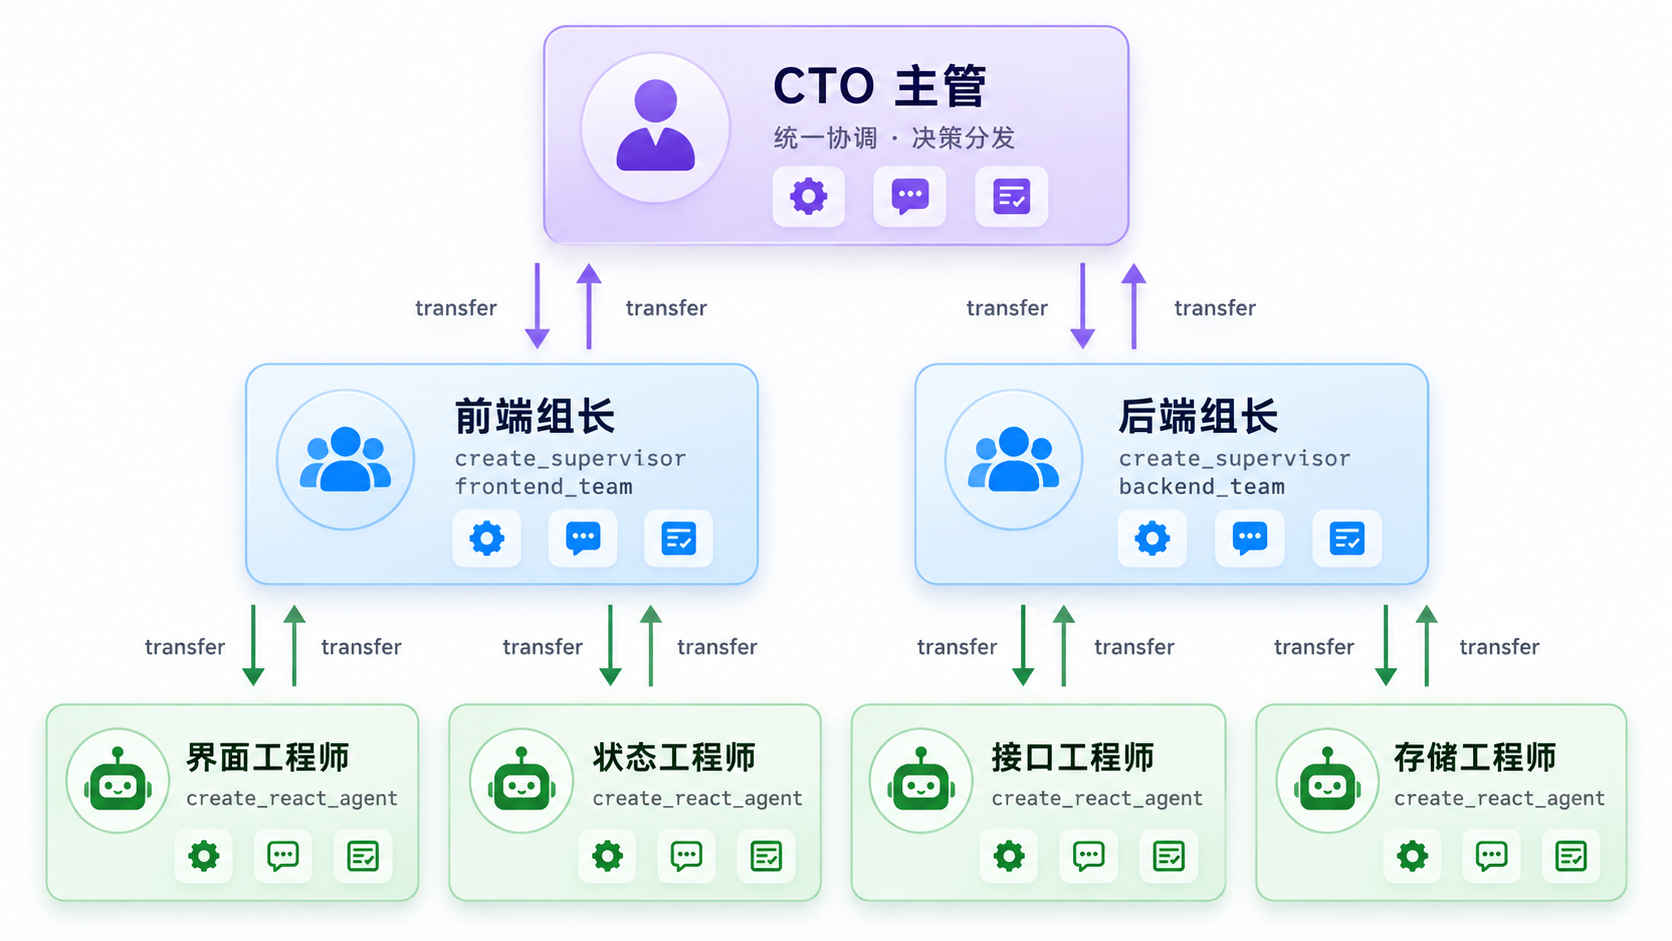
也就是说,一个组长本身也是个主管,但对 CTO 来说,组长就是“一个可以派活的下属”, CTO 根本不关心组长内部是怎么运作的 。
代码里最值得盯着看的就是这几行:
frontend_team = create_supervisor(
  agents=[fe_ui, fe_state], model=model, ...
).compile(name="frontend_team")

backend_team = create_supervisor(
  agents=[be_api, be_db], model=model, ...
).compile(name="backend_team")

top = create_supervisor(
  agents=[frontend_team, backend_team], # 注意这里传进去的不是 worker
  model=model, ...
).compile()
top这一层的 agents 参数里,放的是两个编译好的 Supervisor,不是普通的 worker—— 这就是嵌套的落点 。
跑起来之后,整条协作轨迹大致是这样的:
用户 → CTO
 → 转交给前端组
   组长派 UI 工程师 → 派状态工程师 → 组长汇总 → 交回 CTO
 → 转交给后端组
   组长派接口工程师 → 派存储工程师 → 组长汇总 → 交回 CTO
 → CTO 综合成一份交付简报
关键在于,这条路径里 没有一步是代码写死的 。CTO 先派给谁、组长先找哪个工程师,全是模型当场做的决定。换句话说,从上到下每一次“转交”,都是 当前那一层的主管自己拿的主意 。
这也是 LangGraph 在这个模式上最大的优势: 图结构本身就能表达层级 ,多层自主不需要绕弯子。
OpenAI Agents SDK:把 Agent 包成 Tool
OpenAI Agents SDK 没有专门为层级设计一个构造器,它靠的是另一个思路:把一个 Agent 包装成另一个 Agent 能调用的工具( as_tool )。
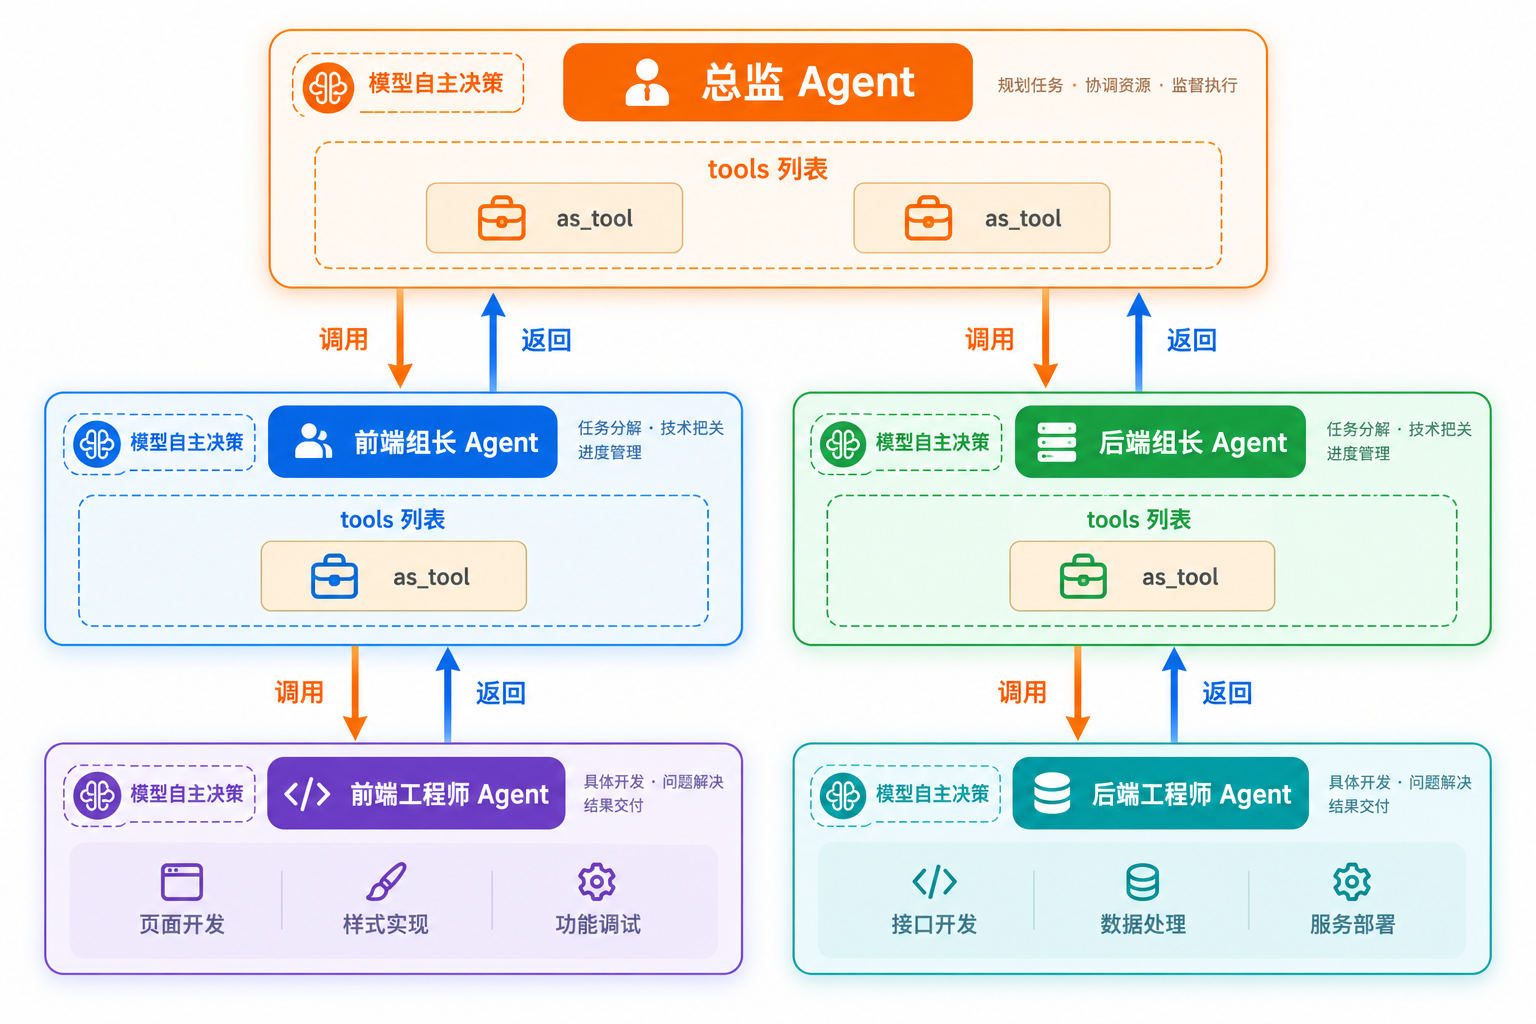
上一层的做法是单层——主管把专家包成工具。这里往上再叠一层: 组长把工程师包成工具,总监再把组长包成工具 。
def make_lead(side):
  eng = Agent(name=f"{side}_eng", ...)
  return Agent(
    name=f"{side}_lead",
    tools=[eng.as_tool(...)], # 第一层:组长把工程师包成工具
    ...
  )

fe_lead = make_lead("前端")
be_lead = make_lead("后端")

cto = Agent(
  name="cto",
  tools=[fe_lead.as_tool(...), be_lead.as_tool(...)], # 第二层:总监把组长包成工具
  ...
)
运行的时候,总监调用“问前端组长”这个工具,前端组长在自己内部又会去调“问前端工程师”这个工具—— 一次调用连环触发下一层的调用 ,层级就这样叠出来了。
和 LangGraph 一样,这两层调用 没有一步是代码预先定死的 :总监要不要问组长、先问哪个,是总监自己决定的;组长要不要调工程师,也是组长自己决定的。所以按前面立的判据,它同样成立。
两家的差别可以简单归纳一下:
| 维度 | LangGraph | OpenAI SDK |
|---|---|---|
| 核心方式 | Supervisor 嵌套 | agents-as-tools 嵌套 |
| 层级表达 | 显式(图结构自带层级) | 隐式(藏在工具调用里) |
| 控制方式 | transfer 转交 | tool call |
| 主要代价 | 图结构相对复杂 | Token 和调用轮次涨得快 |
有一点要提醒:两层嵌套意味着总监一次调用可能会触发组长再调工程师, max_turns 这类参数一定要给够,不然很容易在中途就被截断。
另外三家,为什么做不到
按照前面那条判据—— 每一层都要模型自主派单、下层还能自主往下派 ——剩下的 CrewAI、MAF、Claude Agent SDK 都不成立。但 三家卡住的地方各不相同 ,值得分开说清楚,这比硬凑一段似是而非的多层代码更有意义。
CrewAI:单层是真的,跨层是代码拼的
CrewAI 的 Process.hierarchical 配上 manager_llm ,manager 确实是模型自主派单,单层的 Supervisor 完全成立。但它 没有跨 Crew 的层级机制 ——要搭三层结构,只能在外面写代码依次跑几个 Crew,把上一个的产出手动塞进下一个的任务描述里。“总监把活派给哪个组”这一跳,是 代码固定的顺序 ,不是框架自己表达的语义。
MAF:没有层级构造器,写出来本质是流程编排
微软的 MAF 五种官方编排模式里没有专门给层级用的构造器。要多层,只能用 as_agent 把总监、组长、工程师各自建出来,再用代码把“谁先答、谁后答”逐行写死。这条路能跑,但每一层“派给谁”都是 代码决定的 ,模型只是在被点到名的位置产出内容——这不是分层协同,是 套了组织架构名词的流程编排 。
Claude Agent SDK:被一条官方规则直接封死
它的 subagent 机制是主智能体挂一组子智能体,单层没问题。但分层协同要求组长这一层的 subagent 还能再往下派工程师,也就是 subagent 自己再创建下一层的 subagent ——而官方文档里有一句很直白的话:
「Subagents cannot spawn other subagents.」 —— 子智能体不能创建其它子智能体
这条规则把结构 锁死在“主智能体 + 一层 subagent” ,没有第三层的空间。
这不是缺陷,更像是刻意的选择。Claude Agent SDK 的世界观是 “一主多仆” :一个强大的主智能体,管理一组各有专长但彼此平级的 subagent。它把复杂度都 押在了单层编排和把单个 subagent 做强 这件事上,而不是支持任意深度的嵌套组织。官方文档给的替代方向也印证了这一点:真要嵌套委派,改用 Skills,或者从主对话里串联多个 subagent。
3. 世界观决定模式上限
这五家的差异其实指向一个更普遍的判断方法:一个框架支持哪些协作模式, 根子上是设计哲学决定的 ,而不是功能堆得多不多。
LangGraph:把世界看成一张图
节点可以自由组合,Supervisor 嵌套 Supervisor 天然成立。
OpenAI Agents SDK:把 Agent 看成可互相包装的 Tool
递归组合是顺手的事。
CrewAI:把世界看成一支团队
角色、任务、流程都是它的主场,跨团队的组织层级不在它的语义里。
MAF:把自己定位成企业级编排体系
重心在工具集成和单层编排,不在递归层级。
Claude Agent SDK:把世界看成“一主多仆”
层级嵌套对它来说天然不成立。
选框架的时候,与其一个个去查“这个框架有没有 X 功能”,不如先想清楚 “这个框架怎么看待 Agent 之间的关系” 。
4. 一张表和一个简单的判断顺序
| 框架 | 出品方 | 支持 | 实现方式 | 一句话点评 |
|---|---|---|---|---|
| LangGraph | LangChain | 原生 | create_supervisor 嵌套 | 多层自主最完整,每层都是真主管 |
| OpenAI SDK | OpenAI | 原生 | 嵌套 agents-as-tools | 极简但 token 开销大 |
| CrewAI | CrewAI 公司 | 不适配 | 单层原生 + 外层代码串 Crew | 单层真,跨层是代码模拟 |
| MAF | Microsoft | 不适配 | as_agent + 代码固定顺序 | 写出来本质是流程编排 |
| Claude SDK | Anthropic | 不适配 | — | 官方规则封死,两层到顶 |
真要落地,可以按这个顺序问自己三个问题:
1. 任务复杂到天然需要分组分工吗?不需要的话,一个 Supervisor 就够, 别硬凑层级 。
2. 是不是要求每一层都能自主决定派给谁?如果流程本身就是固定顺序, 直接用代码编排(Workflow)反而更省心也更好调试 。
3. 两条都成立的话,看你在哪个生态:已经在用 LangGraph,直接嵌套 create_supervisor ;已经在用 OpenAI SDK,嵌套 agents-as-tools 也一样成立。如果两边都没有,认真考虑换框架——真有多层组织的需求, 换框架比硬拼更划算 。
如果两个 Agent 就能解决问题,别为了“架构看起来高级”硬塞三层。分层解决的是复杂度分治,不是“Agent 数量不够”的问题。层级越深,调试起来越麻烦,出了问题很难说清是哪一层的锅。
总结
Workflow 有固定流程,Supervisor 有一个中央主管,Hierarchical 有多层主管——但这三种模式其实都有一个共同点: 总有一个明确的上层控制者在统筹全局 。
Swarm 协作模式
Swarm 跟前面所有模式最本质的区别:没有谁凌驾于谁之上, 谁在跟用户说话 ,谁就自己决定下一步——控制权 交出去就不收回。
用户找客服,说手机要退款。退款专员接过来,问了两句才发现,这压根不是退款那么简单——手机本身有质量问题,得先做技术鉴定。于是退款专员没有把用户打回给分诊台重新排队,而是 直接把这个人转给了技术专员 。技术专员接手,继续往下聊。
整个过程里, 没有谁重新派单,没有主管介入协调 ,甚至连“分诊台”都只在最开始露了一面。
这时候一个问题就冒出来了: 如果没有人管,Agent 怎么知道下一步该轮到谁?
前面几种多 Agent 协作方式,其实都有一个共同点—— 总有个地方在管着“下一步去哪”这件事 。代码写死顺序的,是流程说了算;有个主管统一派单的,是主管说了算;一层一层往下委派的,是上级说了算。这一次不一样,没有谁凌驾于谁之上, 谁在跟用户说话,谁就自己决定接下来怎么办 ,而且一旦决定了,就不会再收回。
这种模式有个名字,叫 Swarm 。用一句话概括就是:
平级 Agent + 自主转交 + 控制权不回收
三个词, 无中心、平级互转、控制权接力 。这一篇讲清楚:它到底怎么实现, 五个主流框架谁真支持、谁装装样子、谁压根做不了 ,业界又为什么对它爱恨交织。
从“树”到“网”
前面几种结构画出来都是 有根的树,或者带中心的星 :代码链式往下走,主管坐在中间发号施令,总监往下管主管、主管往下管专员。不管怎么变,总有一个明确的“上面”。
Swarm 把这个“上面”直接拿掉了。 剩下的是一张网 ,任何一个节点都可能是下一刻真正在做事的那个人,控制权不再固定流向谁,而是 在平级节点之间自由传递 。
handoff
很多人对“转交”的理解可能是这样的:Agent 说了句“请技术专家继续为您服务”,然后就没有然后了。 这只是嘴上说说 ,系统层面压根没发生任何事——用户下一句话该发给谁, 系统根本不知道 。
真正的 handoff 是这样运作的:Agent 在自己的工具列表里,挂着一个叫 transfer_to_X 的特殊工具。它判断该转交了,就调用这个工具,不是去查天气或者查数据库,而是 实打实地发起一次控制权转移 。框架识别到这是个 handoff 动作,就把对话的接力棒从当前 Agent 递给 X,X 带着完整的上下文接着往下聊,原来那个 Agent 就此退场, 不会再自动拿回控制权 。
所以 handoff 的本质就一句话:
「它是一次特殊的工具调用,而不是一句话术。」
拿 Swarm 跟前面讲过的 Supervisor 模式放一起比一比,差别就很直观了:
| 维度 | Supervisor | Swarm |
|---|---|---|
| 谁决定下一步 | 中央主管 | 当前正在服务的 Agent 自己 |
| 控制权最后去哪 | 迟早回到主管手里 | 交出去就不收回了 |
| 整体结构 | 星形,有中心 | 网状,没中心 |
系统怎么记住“现在轮到谁”
handoff 本身不难理解,真正麻烦的是后面这件事。
还是刚才那个场景:用户第一句话被分诊台转给了退款专员,退款专员问“麻烦提供一下订单号”,用户回了订单号——这第二句话, 理应直接落到退款专员手上 。可如果系统没有专门记住“现在是退款专员在接待”,那这句“订单号是 xxx” 到底该发给谁 ?总不能每一轮都从分诊台重新分一遍。
所以 Swarm 要跑得起来,必须有个东西把 “当前正在接待用户的是谁”给记下来 ,业界管这个叫 active_agent 。
这句话可以说是理解 Swarm 工程落地的关键:
「Swarm 真正难的从来不是“怎么转”,而是“转完之后怎么记住转到哪儿了”。」
三家把 Swarm 焊进骨子里的框架
OpenAI Agents SDK:handoff 是它的母语
OpenAI 早年那个实验性质的 Swarm 库,后来被 Agents SDK 接了棒,而接过来的核心正是 handoff 这套机制——它是这个 SDK 仅有的四个核心原语之一 ,官方文档第一个示例讲的就是客服转接。可以说 handoff 不是它顺手能做的附加功能,是 设计之初就摆在台面上的招牌能力 。
写起来也确实简单,每个 Agent 定义时用 handoffs=[...] 列出它能转给谁,框架自动生成对应的转交工具挂上去。真正能体现“平级互转”的,是这么两行代码:
triage.handoffs = [refund, tech]
refund.handoffs = [tech] # 退款专员不用回分诊台,直接转给技术专员
第二行才是点睛之笔 。退款专员发现问题超出自己的处理范围,不需要绕回分诊台重新走一遍流程,直接把人递给技术专员——这才是 真正意义上的平级互转 ,而不是层层上报。
判断这套东西是不是真的在工作,不能只看最后那句回复说得漂不漂亮, 得去看接力轨迹 。分诊台转给退款专员,退款专员又转给技术专员,两次 handoff,没有一次绕回中心——轨迹对了,才说明 控制权是真的在网上流动 ,而不是嘴上说说。
LangGraph:把“记忆”这件事做成了官方能力
LangGraph 也有一个专门的官方扩展包叫 langgraph-swarm ,跟做集中调度的 langgraph-supervisor 并列。它最值钱的地方,就是 内建了 active_agent 的状态管理 ——前面说的那个“怎么记住轮到谁”的难题,它不需要你自己写代码去解决。
代码里最关键的一行,反而不是那些造 handoff 工具的部分,而是这个:
checkpointer = InMemorySaver()
swarm = create_swarm(agents=[refund, tech],
default_active_agent="refund").compile(checkpointer=checkpointer)
没有这行, active_agent 跨轮就丢了,下一句话又不知道该发给谁了。这也印证了前面那句话—— Swarm 工程上真正的坎 ,从来不是转交动作本身,而是转完之后 这个状态怎么存、怎么在下一轮对话里正确取出来 。
MAF:一个不太直观、但踩了就报错的必填参数
MAF 提供了一个叫 HandoffBuilder 的构造器,自动给参与者注入转交工具,组织成互相可达的 mesh 结构。用法本身不复杂,但有个坑值得单独拎出来说: 每一个参与者都必须显式开启一个参数 ,
require_per_service_call_history_persistence=True漏掉哪怕一个, build() 直接抛 ValueError 。
两条边界,一堵撞了两次的墙
CrewAI:能拼出来,不等于原生支持
CrewAI 骨子里把多 Agent 系统看成 “一支有明确角色分工的团队” ,关心的是谁负责什么、流程怎么走。在这套世界观里,压根没有“控制权临场决定该转给谁”这回事——角色是安排好的,流程是定义好的。
它的 Flows 能用事件链模拟出“A 做完触发 B”这种顺序流转,看起来像那么回事,但这本质上还是单向的、预先定义好走向的流程编排,不是 Swarm 那种“谁都能转给谁、转给谁由当前节点临场决定”的平级互转。 形似神不同 ,能拼出个近似效果,但不是原生支持。
Claude Agent SDK:第二次撞上同一堵墙
讲分层协同那次,我们已经因为一条官方硬性限制判过 Claude SDK 死刑——subagent 不能再创建下一层 subagent。这次讲 Swarm,又撞上了 一模一样的规矩 。官方文档写得很直白:
"Subagents cannot spawn other subagents."
分层协同需要的是“往下派”,Swarm 需要的是“往旁边转”,Claude SDK 的结构里从头到尾只有“主 Agent 统一调度一组互不可见的 subagent”这一条单向通路。subagent 之间彼此看不见,更谈不上互相转交控制权。 同一条规则,连拦了两种模式 。
这堵墙背后的道理,比这堵墙本身更值得记住:
「一个框架能撑起哪些协作模式,根子上是它的设计世界观决定的,不是功能堆得多不多。」
LangGraph 把世界看成一张可以自由组合的图 ,所以嵌套也好、接力也好,都天然成立;Claude SDK 把世界看成“一个强大的主脑加一群互不知情的助手”,所以嵌套和平级互转,对它来说天然就不成立。选型的时候与其一个个功能去查有没有,不如 先想清楚这个框架把复杂度押在了哪儿 。
业界为什么对 Swarm 有所保留
不是没道理的保留。LangChain 自己做过的多 Agent 架构基准测试,点出了 两个实打实的软肋 。
软肋一:可扩展性
每个 Agent 都得知道所有其他 Agent 的存在,还得挂上能转给每一个人的工具,Agent 数量一多,这套互相认识、互相能转的关系网, 维护成本是平方级往上涨的 。
软肋二:控制流
handoff 天生是顺序执行的,一个 Agent 在把控制权交出去之前, 没法同时并行调用好几个工具去干别的事 。
所以业界普遍的默认选择是: 先上集中调度 ,它对子 Agent 的假设最少、最容易控制;Swarm 更多时候是特定场景才拿出来用的解法, 而不是默认首选 。
五个框架说明
| 框架 | Workflow | Supervisor | Hierarchical | Swarm |
|---|---|---|---|---|
| LangGraph | 原生 | 原生 | 原生 | 原生 |
| OpenAI SDK | 官方示例级 | 原生 | 原生 | 原生 |
| CrewAI | 原生 | 原生 | 不适配·多层 | 可拼装 |
| MAF | 原生 | 原生 | 不适配·多层 | 原生 |
| Claude SDK | 官方示例级 | 原生 | 不适配 | 不适配 |
LangGraph 全行覆盖,它把世界看成可组合的图,嵌套和接力对它来说都是自然而然的事。OpenAI SDK 紧随其后, handoff 是它的母语 ,四个核心原语用起来最短平快。CrewAI 在流程编排和集中调度上顺得很,但一涉及多层组织或者自由互转,就撞上了它角色化团队的世界观边界。
MAF 各方面都够得着,但要具体看是哪个 Builder, 别一竿子打翻 。Claude SDK 集中调度是看家本领,一到分层和 Swarm 就因为“一主多仆”的设计哲学直接亮红灯。
没有哪个框架四种模式都是最优解, 偏科是设计哲学决定的必然结果 。选型的第一步,从来不是去查“这个框架支持不支持某个功能”,而是先想清楚手上这个任务, 到底落在这张表的哪一行 。
一个简单的判断顺序,基本能覆盖大部分场景:
1 流程是不是固定的?固定就用 Workflow 。
2 不固定,有没有一个中心角色统一决策?有就上 Supervisor 。
3 没有中心角色,但有明确的上下级关系?那是 Hierarchical 。
4 都不是,任务会随着用户意图不停漂移?这才是 Swarm 该出场的时候。
总结
三句话收个尾。
1. Swarm 要解决的不是“任务有多复杂”,而是 控制权需不需要在平级 Agent 之间自由流动 。
2. 它最大的优势不是“去中心化”这个听起来很酷的词,而是 能让会话的焦点真正跟着用户的意图走 。
3. 它最大的问题也恰恰来自这个优势——没有了中心, 连接关系怎么维护、状态怎么存、边界在哪儿 ,全都跟着变复杂了。